10分钟搭建本地语音AI Agent:全链路实战
从零开始搭建完整的本地语音交互Agent系统。本文带你逐步串联语音识别(STT)、大模型(LLM)、语音合成(TTS)四个核心模块,无需云端API,对着麦克风说话即可获得语音回复。学完后你将独立掌握本地语音Agent的搭建流程,并根据硬件条件灵活替换组件。
10分钟搭建本地语音AI Agent:全链路实战
开篇:为什么我们需要本地语音Agent?
做开发这些年,我一直关注一个问题:很多语音助手、智能客服的demo看起来很酷,真到自己部署时,要么被云端API费用劝退,要么延迟高到影响体验,要么干脆跑不起来。
团队内部需要快速验证语音交互场景时,每次调云端API、注册账号、担心调用额度,效率大打折扣。
本文目标明确:从零开始,在本地搭建完整的语音交互Agent。你说一句话,它能听到、理解并用语音回复你。全部开源、全本地运行、无需云端API。
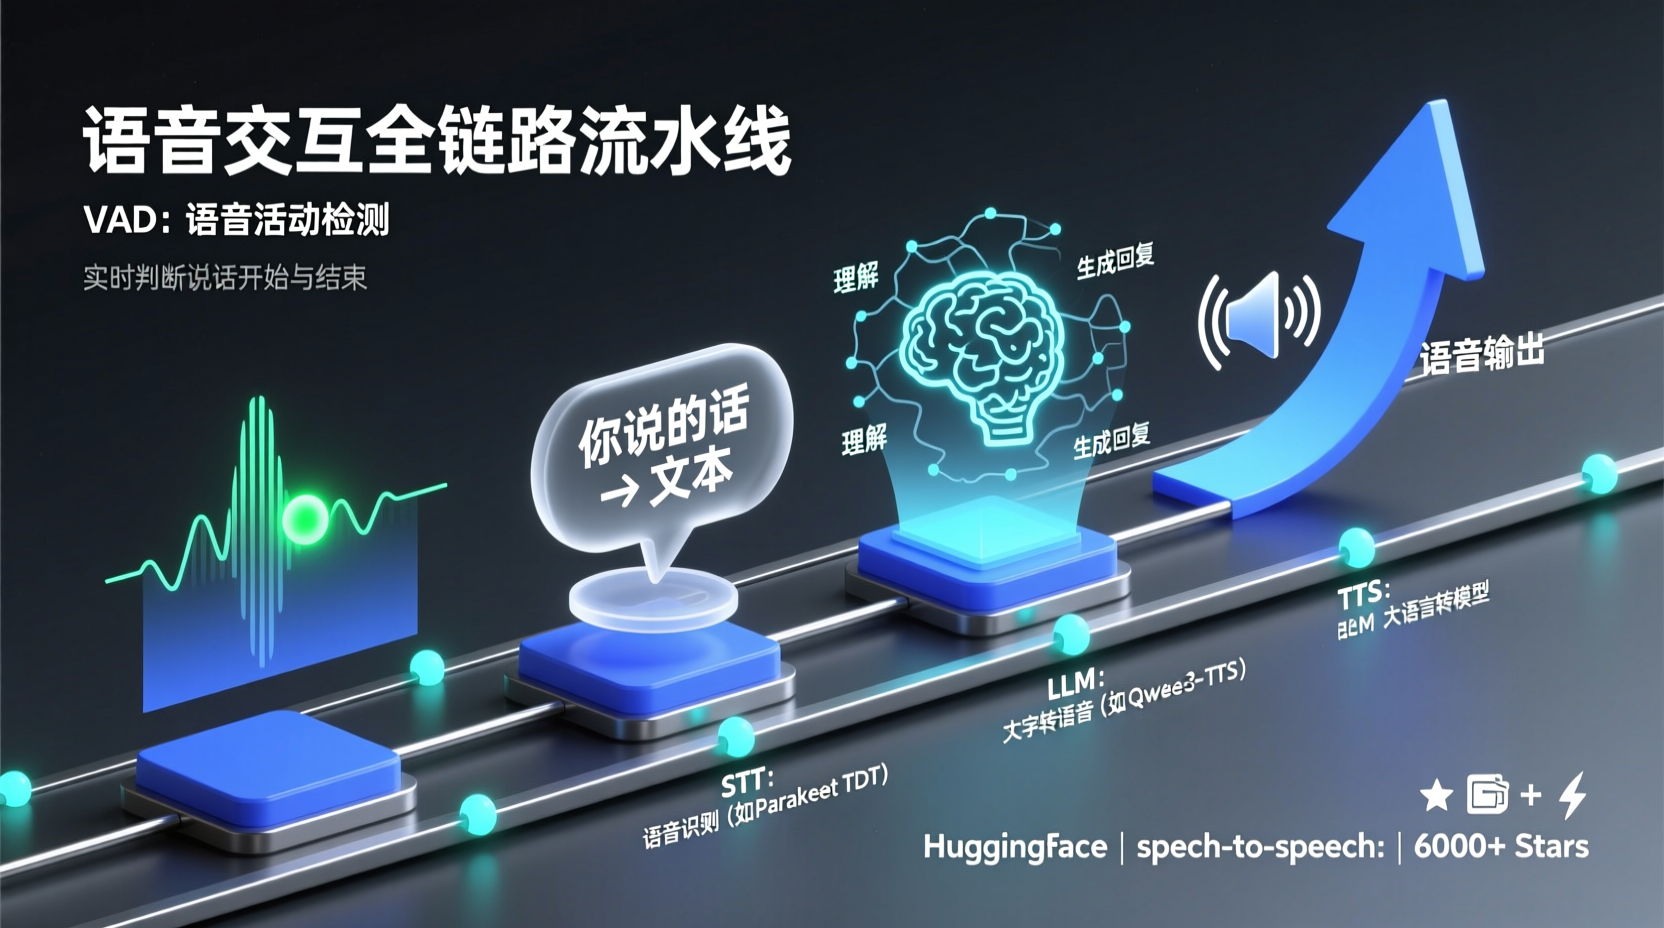
项目是HuggingFace官方的 speech-to-speech,6000+星,核心思路是把语音交互拆成四个可替换模块,像搭积木一样组装。
架构拆解:一条语音流水线
项目的核心逻辑非常直观,就是一条处理流水线:
- VAD(语音活动检测):判断你是否在说话,何时结束
- STT(语音转文字):将你说的话识别成文本
- LLM(大语言模型):理解文本并生成回复
- TTS(文字转语音):把回复合成语音播放出来
每个模块都能独立替换。根据机器配置、语言需求、延迟要求,自由组合最适合的方案。
前置条件
动手前,确保环境符合要求:
- Python 3.10 或更高版本(硬性要求)
- macOS Apple Silicon 体验更顺畅(项目对MPS有专门优化)
- NVIDIA 显卡支持更多TTS/STT后端
- 具备基础终端操作能力
无需掌握深度学习底层原理,但了解模型如何"加载"和"推理"会有帮助,这能解释某些步骤为什么会慢。
快速上手:三步跑通最简流程
第一步:安装
bash
pip install speech-to-speech该命令默认安装语音识别(Parakeet TDT)、大模型调用(OpenAI兼容API)、语音合成(Qwen3-TTS)三个核心组件。macOS 会自动适配 mlx-audio 后端;Linux 用户默认走 GGML 加速。
如遇CUDA版本问题,可先处理依赖再安装:
bash
pip install "qwentts-cpp-python==0.3.0+cu124" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cu124
pip install speech-to-speech
第二步:理解运行模式
项目提供多种运行模式,新手推荐 local 模式——直接调用电脑麦克风输入和扬声器输出:
bash
speech-to-speech --mode local --stt parakeet-tdt --tts qwen3 --model_name ggml-org/gemma-4-E4B-it-GGUF --responses_api_base_url http://127.0.0.1:8080/v1 --responses_api_api_key ""参数逐段拆解:
--stt parakeet-tdt:使用NVIDIA的Parakeet模型做语音识别(支持25种欧洲语言)--tts qwen3:使用Qwen3-TTS做语音合成--model_name和--responses_api_base_url:指定本地运行的LLM服务地址--responses_api_api_key "":空密钥,本地服务无需验证
核心思想很直接:告诉系统每个环节用什么工具、在哪调用。就像在命令行里拼乐高。
实战:搭建完全离线语音助手
启动本地LLM服务
第一个终端,用llama.cpp启动大模型服务:
bash
llama-server -hf ggml-org/gemma-4-E4B-it-GGUF -np 2 -c 65536 -fa on --swa-full这会在 http://127.0.0.1:8080 启动OpenAI兼容API服务。-hf 参数自动从HuggingFace下载模型,首次运行需等待几分钟。
启动语音Agent并对话
打开第二个终端:
bash
speech-to-speech \
  --mode local \
  --stt parakeet-tdt \
  --tts qwen3 \
  --model_name "ggml-org/gemma-4-E4B-it-GGUF" \
  --responses_api_base_url "http://127.0.0.1:8080/v1" \
  --responses_api_api_key "" \
  --responses_api_stream \
--enable_live_transcription运行后,直接对着麦克风说话。系统自动完成检测、识别、推理、合成的完整闭环。--enable_live_transcription 会在终端实时显示识别到的文字和生成的文本。
无需编写任何代码,组合命令参数即可运行。
Mac一键优化
macOS 用户可直接使用最优参数集合:
bash
speech-to-speech --local_mac_optimal_settings该命令自动设置MPS设备、MLX后端、本地模式等Apple Silicon适配配置。可在此基础上指定特定模型:
bash
speech-to-speech --local_mac_optimal_settings --model_name mlx-community/Qwen3-4B-Instruct-2507-bf16常见问题排查
CUDA版本不匹配
Linux默认安装的 qwentts-cpp-python 依赖CUDA 12.8。机器是CUDA 12.4或13.x时,需先安装对应版本:
bash
pip install "qwentts-cpp-python==0.3.0+cu124" \
  -f https://huggingface.co/datasets/andito/qwentts-cpp-python-wheels/tree/main/whl/cu124
pip install speech-to-speech
numpy版本冲突
DeepFilterNet音频增强要求 numpy<2,Pocket TTS要求 numpy>=2。两者无法共存,需根据核心需求取舍。
模型首次加载慢
首次启动会下载几个GB的模型权重。STT(Parakeet)、TTS(Qwen3-TTS)和LLM(Gemma 4约2.7G)按需下载。下载完成后后续启动速度正常。
中文支持
默认Parakeet TDT支持25种欧洲语言,不覆盖中文。需要中文语音识别时,替换为Whisper系列:
bash
speech-to-speech \
  --stt whisper \
  --stt_model_name large-v3 \
  --language zh
Whisper计算量更大、延迟更高,属于取舍问题。
Python版本过低
项目严格需要Python 3.10+。系统默认是3.8或3.9时,使用conda或pyenv创建新环境。
总结与进阶路径
回顾完整流程:安装工具包、启动本地LLM服务、用 --mode local 串联VAD→STT→LLM→TTS四个模块、对着麦克风说话获取语音回复。
核心思路不是写代码,而是理解每个组件的职责和边界,通过CLI参数拼装起来。这恰好是企业搭建语音Agent最实用的路径——先跑通,再定制。
进阶方向:
- 尝试
--mode realtime,通过WebSocket接入自有客户端或前端应用 - 探索不同TTS后端(Kokoro、Pocket TTS、MMS)的音色效果
- 学习OpenAI Realtime API协议,开发专属语音交互客户端
- 关注多语言切换(
--language auto)实现跨语种语音对话
动手跑起来,你会发现离真正产品只差几步调优。